Un agent IA peut sembler meilleur après une modification et échouer sur une tâche qu’il réussissait auparavant. Google a consacré un billet du 28 octobre 2026 aux évaluations dans Agents CLI, avec une méthode de comparaison progressive. Le sujet intéresse les équipes qui veulent dépasser la démonstration ponctuelle pour suivre un comportement dans le temps.
L’enjeu n’est pas de produire un score impressionnant dans une présentation. Il consiste à savoir ce que le système fait mieux, ce qu’il fait moins bien et si les changements répondent au besoin réel de l’entreprise. Un progrès global peut cacher une régression importante sur un cas particulier.
Un parcours de test et de comparaison
La publication officielle de Google présente une boucle comprenant des cas de test, leur exécution, une évaluation et l’examen des échecs. Elle décrit aussi la comparaison de modèles et de traces, ainsi que des exécutions planifiées avec alertes sur des seuils. L’objectif est d’observer les changements plutôt que de se fier seulement à l’impression laissée par une conversation réussie.
Ce billet expose une méthode et des outils pour les développeurs. Il ne démontre pas qu’une entreprise peut mesurer toute la qualité d’un agent avec un indicateur unique, ni qu’une série de tests élimine tous les problèmes possibles en production.
Le choix des exemples reste décisif. Une équipe peut commencer par les demandes qu’elle rencontre réellement, puis ajouter les exceptions qui ont déjà posé problème. Cette sélection donne au score une signification plus concrète qu’une collection de questions faciles choisies uniquement pour obtenir un résultat flatteur.
Partir des tâches qui comptent vraiment
Un test utile doit représenter un travail identifiable. Retrouver une référence, résumer un dossier ou préparer une action ne demandent pas les mêmes critères de réussite. Avant de comparer les modèles, l’équipe doit donc décrire ce qu’elle attend et ce qu’elle considère comme une erreur importante.
Les cas ordinaires ont leur place, mais les exceptions connues aussi. Un document incomplet, une donnée contradictoire ou un accès refusé révèlent parfois davantage qu’une question facile. Le système doit savoir reconnaître une limite plutôt que compléter silencieusement ce qui lui manque.
Notre dossier sur le choix entre agent IA et automatisation classique rappelle l’intérêt de partir de la tâche. Un changement de modèle ne corrige pas nécessairement un problème qui vient du processus retenu.
Conserver des résultats comparables
Pour juger une modification, il faut savoir ce qui a réellement changé. Si le modèle, les consignes, les outils et les documents évoluent en même temps, attribuer l’écart à un seul élément devient difficile. Une comparaison structurée garde une trace de ces conditions.
Les résultats doivent aussi être examinés au-delà de la moyenne. Un système peut mieux répondre à beaucoup de demandes simples tout en ratant quelques situations essentielles pour l’activité. Les responsables métier doivent pouvoir repérer ces cas et décider de leur poids dans l’évaluation.
La lecture de quelques traces aide à comprendre les écarts. Une réponse finale correcte peut cacher une étape inutile ou un accès excessif. À l’inverse, une formulation imparfaite peut accompagner un raisonnement exploitable. Le contrôle gagne à distinguer ces dimensions.
Les alertes doivent conduire à une action prévue
Une exécution nocturne peut signaler une baisse, mais encore faut-il savoir qui la reçoit et ce qui doit se passer ensuite. Une alerte ignorée ne protège pas davantage le service qu’un tableau jamais consulté. Le suivi doit rester proportionné à l’importance des tâches.
L’équipe peut définir quelques suites possibles : examiner le cas, suspendre un déploiement ou revenir à une configuration connue. Cette préparation évite de découvrir le circuit de décision au moment où un problème est déjà visible par les utilisateurs.
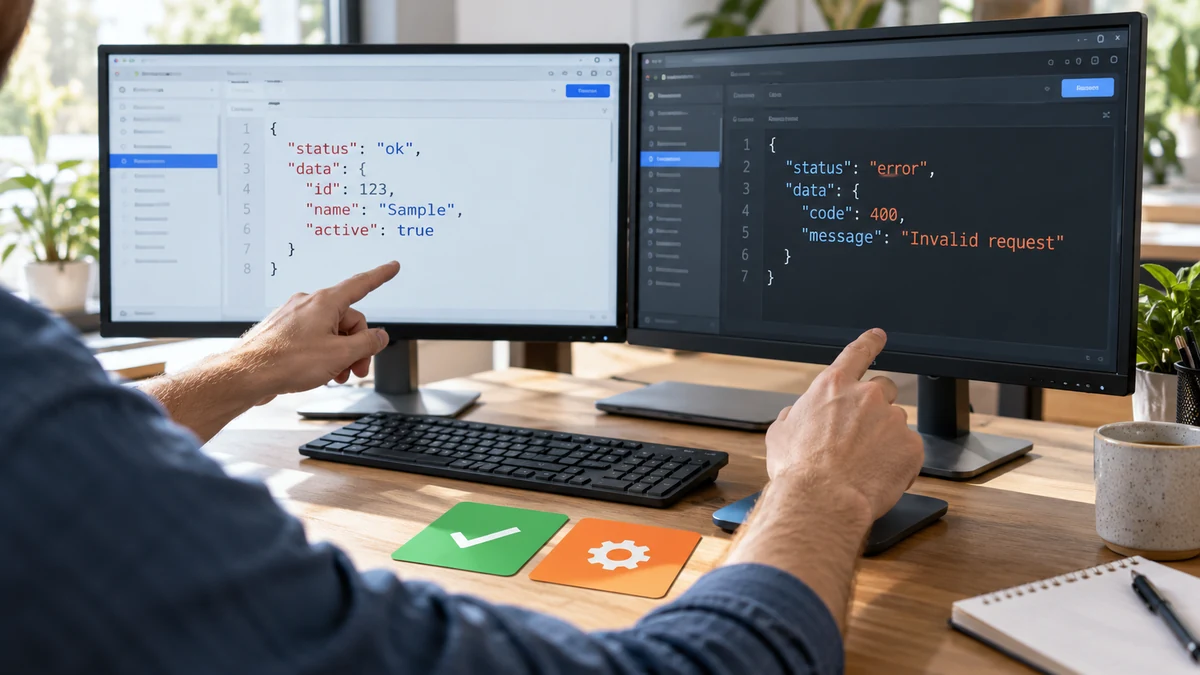
Notre article sur la démonstration des erreurs et doublons dans une intégration apporte une logique complémentaire. Le fonctionnement attendu comprend aussi les situations où le système ne peut pas terminer normalement.
Une méthode de suivi, pas une certification générale
Le billet de Google propose de rendre les évolutions plus observables. Sa valeur dépendra des cas choisis, des critères et de la manière dont l’équipe utilise les résultats. Une collection d’exemples trop étroite peut donner une confiance qui dépasse son périmètre.
Pour commencer, quelques tâches importantes bien décrites peuvent suffire. L’équipe compare, lit les échecs et complète progressivement son jeu de tests avec les difficultés rencontrées. Le progrès devient alors une amélioration documentée du travail attendu, plutôt qu’une simple préférence pour la dernière réponse produite par un modèle plus récent.

Je suis Romain, rédacteur passionné par tout ce qui touche au high-tech, à la crypto, et à l’innovation. Diplômé d’une école de marketing à Paris, je mets ma plume au service des dernières tendances et avancées technologiques.